
兄弟们,咱做技术的,谁还没个深更半夜被监控电话炸醒的经历?反正我是搞怕了。每次系统一抖,老板就夺命连环问,那感觉,就像你正搁屋里睡得好好的,天花板塌了。咱今天就掏心窝子聊聊这个让人又爱又恨的“技术系统架构”。我发现好多人对架构的理解,还停在画几个框框,连上线就完事儿了,那玩意儿中看不中用啊!真正到了要命的时候,根本顶不住。
我先给你讲个真事儿,是我一个在金融科技平台干活的哥们儿遇到的,那场面,简直了。说的是他们那套支付结算系统,听着挺唬人吧?微服务架构,拆了十几个服务,贼先进。结果呢,赶上季度末消费高峰,系统直接拉了胯。最开始只是支付渠道那一个模块出了点小毛病,结果十分钟不到,好家伙,跟多米诺骨牌似的,交易鉴权也跪了,用户账户也崩了,响应时间从300毫秒直接干到3秒,交易成功率掉到88%,那得赔多少钱啊 -5?
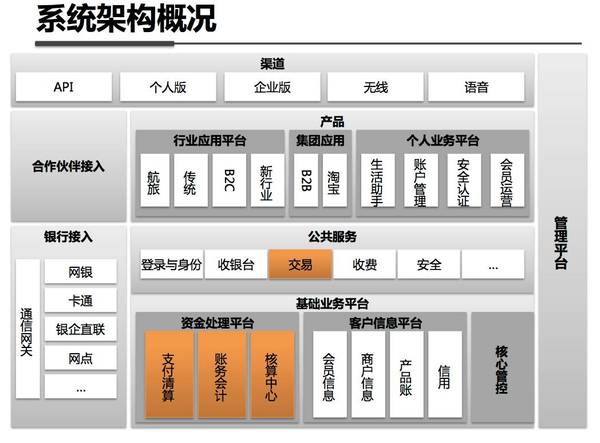
后来查原因,查出来你都不信,不是什么高深的技术难题,就是那个“渠道路由”模块的配置加载写得不讲究。它用的是“本地缓存+定时全量刷新”这么个土办法,而且刷新的时候还没加锁。高峰期的时候,这边正刷着呢,那边几百个请求乌泱泱地来读数据,直接就把内存数据结构给干错乱了,线程卡死一片。这事儿说明啥?说明你那套花里胡哨的技术系统架构,如果连最基本的并发冲突都防不住,那就是个纸老虎,一捅就破。他们后来怎么治的?把那块逻辑重写了,引入了读写锁,又把“全量更新”改成了“增量差分更新”,就这么一改,配置更新耗时从200毫秒压到了30毫秒,线程阻塞率从80%直接降到0.5% -5。你看,这才叫解决问题,而不是光在PPT上讲大道理。
所以说,架构这东西,得落地,得皮实。另一个让我印象特别深的,是杨凌美畅那个案例,做制造业的,500条产线,150万个测点,7x24小时连轴转,那数据量,哗哗的 -8。他们之前用的是开源版的时序数据库,单机单副本,一开始百来条产线的时候还凑合,等规模一上来,全完了。想查个历史告警数据,快的时候1秒,慢的时候几十秒,完全不可控。更要命的是,有一次备份失败,查了半天,数据还丢了一部分,这在生产线上是大事儿,分分钟影响产能分析 -8。

这就是典型的架构设计没给未来留余地,光顾着当下跑通,没考虑万一跪了咋办。他们后来痛定思痛,把底层的技术系统架构整个换血,上了企业版的时序数据库,做了几件事我觉得特别到位:第一,上双副本,数据写两份,一个节点挂了另一个立刻顶上,业务不停;第二,把数据模型从一张一张的普通表,重构成了按业务场景划分的“超级表”,用标签来筛数据。就这么一改,查某个车间100条产线一个月的平均产能,从12秒干到了0.8秒,效率提升了23倍 -8。这就是架构带来的实实在在的收益,不光能抗事儿,还能让数据分析变得丝滑。
还有一个事儿,江南农商银行做核心系统改造,那也是大刀阔斧。你想,银行那核心的信贷核算系统,多金贵,全是账务,一分钱都不能错。他们以前是传统集中式架构,一到月底批量算利息的时候就脑壳疼,性能卡脖子。后来换成基于华为GaussDB的分布式架构,你猜怎么着?各项指标比原来好了320% -2。而且人家还搞了个两地三中心的容灾方案,万一杭州的机房被淹了,能秒级切换到南京的机房去,异地RPO(数据丢失量)小于5秒,RTO(恢复时间)小于145秒 -2。这啥概念?就是哪怕老天爷跟你作对,你的钱和账,系统给你守得死死的。
这就给我们提了个醒,真正牛掰的技术系统架构,它一定是带着“反脆弱”基因的。它不光要考虑到正常业务怎么跑得欢,更要考虑到出事儿的时候怎么不跪,甚至能从故障里学乖。就像那个金融科技的案例,他们后来学精了,引入了“舱壁模式”,把支付、账户、渠道这些核心服务拆成独立的“舱室”,每个舱室有自己的线程池、数据库资源,一个舱漏水了,不会把整条船搞沉 -5。他们还搞了“混沌工程”,定期故意给系统使坏,关几个节点,延迟一下网络,看系统会不会自救,会不会报警。一开始也是手忙脚乱,练了小半年,平均故障恢复时间从15分钟缩短到2分钟 -5。这钱花得值不值?太值了!
所以啊,兄弟们,咱平时琢磨技术,不能老浮在表面,学学新框架,背背面试题。得多往深了想想,你设计的这个东西,在真实的世界里,面对那些操蛋的突发情况,它扛不扛揍?它能不能自己长好?这才是架构师的功力所在。别等出了事儿再拍大腿,那时候黄花菜都凉了。